Multiverse научила модель отказывать только в политической манипуляции
На Qwen3-8B доля отказов на вредные политические запросы выросла с 9,5% до 85%. Без специально подобранных безопасных примеров модель отклоняла и 74% безобидных запросов, предупреждают авторы.
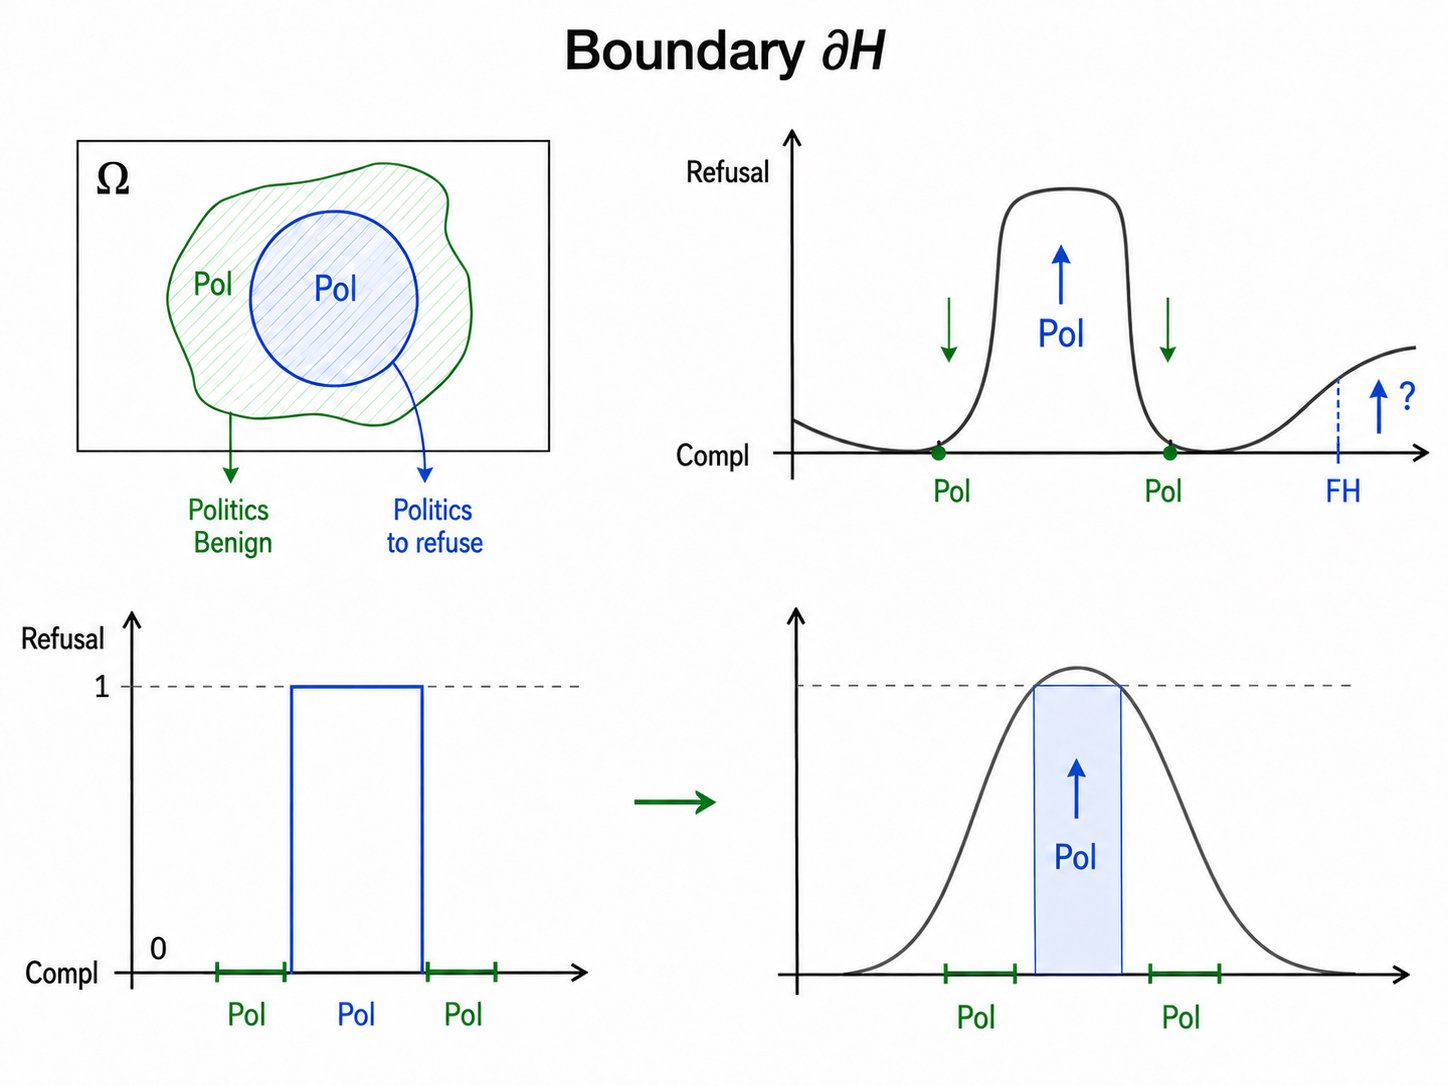
Multiverse Computing предложила способ дообучить модель так, чтобы она отказывала не во всей теме, а только в её вредной части. Например, модель по-прежнему отвечает на фактические вопросы о выборах, но не пишет адресную политическую манипуляцию. Метод описан в статье «Safety for Whom?», которую компания представила в блоге на Hugging Face.
Multiverse Computing — испанская компания, которая занимается сжатием и дистилляцией языковых моделей.
Обычные фильтры безопасности делят запросы по темам: оружие, мошенничество, выборы. По словам авторов, такое деление слишком грубое. Школьному репетитору по обществознанию и чат-боту госслужбы нужна одна и та же модель, но граница допустимого в политике у них разная. Фильтр Llama Guard 31 относит к выборам только ложные сведения об избирательной системе. Убеждение и манипуляция в эту категорию не входят.
Обучающие данные авторы собирали из ответов самой модели: её подталкивали к отказу на вредный запрос и оставляли только ответы, которые фильтр признал настоящим отказом. С одной попытки отказ не получался на 19,88% запросов, это 8 009 примеров. Раньше такие примеры просто выбрасывали, хотя они, возможно, самые трудные. Авторы запускали повторные попытки с всё более сильным нажимом, и доля потерь упала до 0,20%. Ещё 11 955 безвредных запросов, которые звучат опасно, добавили в обучение, чтобы модель привыкала к ним заранее.
На Qwen3-8B доля отказов на вредные политические запросы выросла с 9,47% до 84,75%. На трёх общих тестах вредности — HarmBench, StrongREJECT и WildJailbreak — доля опасных ответов снизилась в среднем с 26,26% до 0,14%. Но у той же версии доля ложных отказов на бенчмарке XSTest2 выросла с 2% до 74%.
«Это грубая машина для отказов, а не более безопасная модель»
авторы исследования Multiverse Computing
Исправить перекос помогли пары запросов на одну тему, которые различаются только намерением: на один модель должна отказать, на другой — ответить. С такими парами доля ложных отказов у самой границы упала с 32,94% до 4,16%. Доля верных отказов снизилась меньше: с 91,88% до 87,72%. Авторы советуют всегда измерять обе стороны: одна доля отказов на вредные запросы ничего не говорит о том, сколько полезных ответов модель потеряла.
Ранее, 10 августа, Multiverse Computing рассказала, как запускать дистилляцию3 моделей на одном GPU-узле вместо четырёх. 25 августа компания показала 4-битную версию GPT-OSS 120B, которая, по её данным, обошла полноточный оригинал.